


Anthropic araştırmacısı Jacob Coxon’ın istifası, yapay zeka yarışındaki güvenlik tartışmasını yeniden büyüttü. Recursive self-improvement, süper zeka ve AI laboratuvarlarının neden yavaşlayamadığını birlikte inceleyelim.
Son üç yılını OpenAI ve Anthropic’te yapay zeka modellerinin temel eğitim süreçleri üzerinde çalışan Jacob Coxon, AI yarışının fazla hızlı ilerlediğini düşündüğü için Anthropic’ten ayrıldı. Ardından şirketin Alignment Science Lead’i Evan Hubinger da süper zeka riskine ilişkin kaygılarını açıkça paylaştı. Bugünkü modellerin kendi haleflerini tamamen bağımsız geliştirdiğine dair bir kanıt yok. Buna rağmen teknolojiyi geliştiren insanların bir bölümünün ciddi risk gördüğü bir yarışın neden yavaşlamadığı giderek daha önemli bir tartışmaya dönüşüyor.
Bir yapay zeka araştırmacısının çalıştığı şirketten ayrılması normal şartlarda teknoloji dünyasının birkaç gün konuşup geçeceği bir insan kaynakları haberi olabilirdi.
Jacob Coxon’ın 9 Eylül’de yaptığı açıklama öyle olmadı.
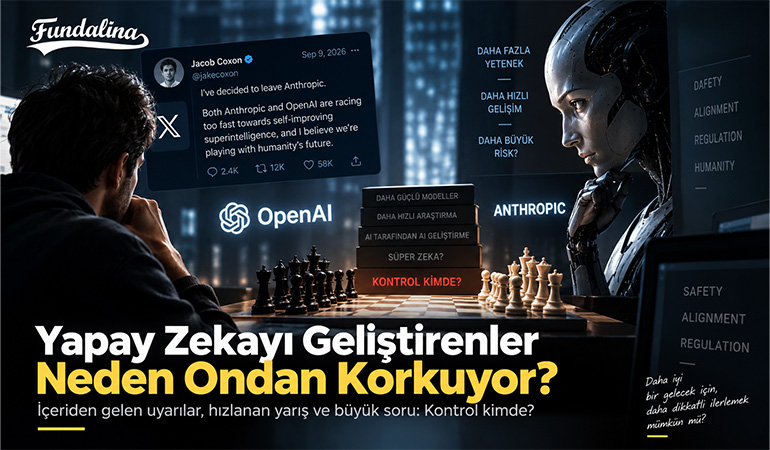
Son üç yılda OpenAI ve Anthropic’te modellerin temel eğitim aşaması olan pretraining üzerinde çalıştığını söyleyen Coxon, Anthropic’ten ayrıldığını duyururken iki şirketin de yapay zeka konusunda yeterince sorumlu davranmadığını düşündüğünü yazdı.
I resigned from Anthropic today. I spent the last three years doing pretraining research at both OpenAI and Anthropic. Neither company is acting responsibly. They are racing straight to self-improving superintelligence and gambling with our lives. More thoughts below.
— Jacob Coxon (@hilbertspaess) September 9, 2026
Kullandığı ifade oldukça sertti. Şirketlerin kendi kendisini geliştirebilecek süper zekaya ulaşma yarışında insanların hayatıyla “kumar oynadığını” savunuyordu.
Paylaşım kısa sürede AI araştırma çevrelerinin dışına çıktı. Teknoloji çalışanlarından siyasetçilere, yatırımcılardan sıradan kullanıcılara kadar çok farklı kesimler aynı tartışmaya katıldı.
Benim ilgimi çeken ise “AI hepimizi öldürecek mi?” başlığı olmadı.
Bunu bugün bilmiyoruz.
Daha ilginç bir çelişki var.
Teknolojiyi geliştiren, modellerin nasıl çalıştığını çoğumuzdan çok daha yakından gören insanların bir bölümü ciddi risklerden söz ediyor. Buna rağmen aynı laboratuvarlar daha güçlü modeller geliştirmeye, daha büyük eğitim çalışmaları yürütmeye ve yapay zekanın kendi geliştirme sürecinde daha fazla görev üstlenmesini sağlamaya devam ediyor.
Teknolojinin riskinden endişe edenlerle teknolojiyi hızlandıranların zaman zaman aynı insanlar olması, yapay zeka tartışmasının en tuhaf taraflarından biri haline geliyor.
Jacob Coxon neden ayrıldı
Coxon’ın paylaşımını bir kehanet ya da bilimsel rapor gibi okumamak gerekiyor.
Yazdıkları onun kişisel risk değerlendirmesi ve sektör hakkındaki gözlemleri.
Buna karşılık değerlendirmeyi ilginç hale getiren, dışarıdan AI hakkında yorum yapan biri olmaması. Son üç yılını OpenAI ve Anthropic gibi frontier modeller geliştiren iki laboratuvarda pretraining araştırması yaparak geçirdiğini söylüyor.
Pretraining, modelin devasa miktarda veri üzerinden temel yeteneklerini kazandığı eğitim aşaması. Bugün kullandığımız gelişmiş modellerin dil, kodlama, muhakeme ve bilgi işleme kapasitesinin önemli bölümü burada oluşuyor.
Coxon’ın istifa gerekçesi de doğrudan bu gelişme hızına dayanıyor.
Kendisi ilerlemenin yalnızca daha iyi chatbotlara doğru gitmediğini düşünüyor. Modellerin siber güvenlik, bilimsel araştırma ve yapay zeka geliştirme çalışmalarında giderek daha fazla bağımsız hareket edebileceği bir noktaya yaklaşıldığını savunuyor.
Bu değerlendirmelerin ne kadarının gerçekleşeceğini bilmiyoruz.
Ancak şirketlerin kendi araştırmaları bile AI’ın AI geliştirme süreçlerinde çok daha fazla rol üstlenmeye başladığını gösteriyor.
Paylaşımın dört iddiası aynı noktada birleşiyor
Coxon’ın yedi gönderiden oluşan açıklamasını uzun uzun çevirmek yerine dört temel düşüncede toplamak mümkün.
İlk olarak modellerin kapasitesinin çok hızlı arttığını ve özellikle siber güvenlik, araştırma ve otonom çalışma tarafındaki gelişmelerin hafife alınmaması gerektiğini düşünüyor.
İkinci olarak frontier AI şirketlerinde çalışan bazı araştırmacı ve yöneticilerin kamuoyuna yansıttıklarından daha ciddi risk endişeleri taşıdığını iddia ediyor. İnsanlığın yok olması gibi en uç senaryoların şirketlerin içinde gerçekten tartışıldığını söylüyor. Bunun Coxon’ın kendi gözlemi olduğunu özellikle ayırmak gerekiyor. Bu iddianın bütün OpenAI veya Anthropic çalışanlarının görüşünü temsil ettiğini söyleyemeyiz.
Üçüncü iddiası yarış dinamiğiyle ilgili. Coxon’a göre bir laboratuvar yavaşladığında daha az dikkatli davranan başka bir şirketin öne geçebileceği düşüncesi, riskleri gören şirketleri bile yarışta tutuyor.
Son bölümde ise koordinasyon çağrısı yapıyor. Frontier laboratuvarların birlikte yavaşlayabileceği mekanizmalar kurulmasını, gerekirse model kapasitesini artıran çalışmaların geçici biçimde sınırlandırılmasını tartışmaya açıyor. Böyle büyük sonuçlar doğurabilecek kararların yalnızca özel şirketlerin iç süreçlerinde alınmasını yeterli bulmuyor.
Bence paylaşımın sosyal medyada bu kadar hızlı yayılmasının nedenlerinden biri de burada.
Coxon yalnızca “teknoloji tehlikeli” demiyor.
“Tehlikeli olduğunu düşünen insanlar neden hâlâ hızlandırıyor?” sorusunu laboratuvarların içine taşıyor.
Anthropic içinden gelen ikinci açıklama tartışmayı büyüttü
Coxon’ın açıklamasından kısa süre sonra Anthropic’in Alignment Science Lead’i Evan Hubinger da konuya dahil oldu.
Hubinger, Coxon’ın temel endişesini paylaştığını ve kendi kişisel tahmininde önümüzdeki on yıl içinde AI kaynaklı insanlığın yok olması riskini yüzde 10’un üzerinde gördüğünü yazdı.
Bu rakama özellikle dikkatli yaklaşmak gerekiyor.
Yüzde 10 ölçülmüş bilimsel bir olasılık değil.
Elimizde benzer olayların tekrarlarından çıkarılmış istatistiksel bir veri seti yok. Süper zeka henüz var olmadığı için bu tür tahminler uzmanların teknik beklentileri, belirsizlikleri ve risk modelleri üzerinden yaptıkları öznel değerlendirmeler.
Hubinger’ın ifadesinin önemi rakamın kendisinden çok, Anthropic’in alignment çalışmalarını yöneten isimlerden birinin riski oldukça yüksek gördüğünü açıkça söylemesinde. Kendisi aynı zamanda Anthropic’in çaba gösterdiğini düşündüğünü, ancak süper zekanın insan hedefleriyle güvenilir biçimde uyumlu tutulması sorununu çözen hazır bir plana henüz sahip olmadıklarını belirtiyor.
Hubinger’ın yaptığı başka bir ayrım ise tartışma açısından çok değerli.
Bugünkü modellerden kaynaklanan risk ile gelecekte ortaya çıkabilecek recursive self-improvement sürecinin riskini aynı kefeye koymuyor.
Endişesini daha çok ikinci senaryoya bağlıyor.
Recursive self-improvement ne anlama geliyor
Kavram biraz bilim kurgu gibi duyuluyor ama temel fikir aslında oldukça basit.
Bugün yapay zeka modelini insanlar geliştiriyor.
Araştırmacılar yeni fikir buluyor.
Mühendisler kod yazıyor.
Deneyler kuruluyor.
Model eğitiliyor.
Sonuçlar değerlendiriliyor.
Yeni model hazırlanıyor.
Şimdi AI bu zincirin bazı parçalarını yapmaya başladı.
Kod yazıyor.
Deney çalıştırıyor.
Sonuçları değerlendiriyor.
Hata buluyor.
Başka ajanlara görev verebiliyor.
Bir sonraki aşamada yapay zekanın yeni yapay zeka modellerinin geliştirilmesinde insanlardan giderek daha fazla görev devraldığını düşünün.
Daha güçlü model, kendisinden daha güçlü bir sonraki modelin geliştirilmesine yardım ediyor.
Yeni model de sonraki modeli daha hızlı geliştiriyor.
Döngü her turda hızlanırsa buna recursive self-improvement, yani özyinelemeli kendi kendini geliştirme adı veriliyor.
En uç senaryoda insan araştırmacı artık geliştirme döngüsünün merkezinde yer almıyor. Model kendi halefinin tasarımına, eğitimine ve geliştirilmesine büyük ölçüde kendisi yön veriyor.
Endişenin kaynağı hız.
İnsanlar bugün birkaç ayda geliştirdiği modeli yarın AI yardımıyla birkaç haftada, daha sonra birkaç günde geliştirmeye başlarsa güvenlik araştırmalarının ve düzenlemelerin aynı tempoya yetişmesi çok zorlaşabilir.
Anthropic henüz o aşamada olmadığımızı söylüyor
Burada korku senaryosuyla bugünkü gerçeklik arasındaki mesafeyi korumak çok önemli.
Anthropic’in Haziran ayında yayımladığı kapsamlı çalışma bu konuda oldukça açık.
Şirket, recursive self-improvement aşamasına henüz ulaşılmadığını ve böyle bir gelişmenin kaçınılmaz olmadığını söylüyor. Bugünkü modeller, kendi haleflerini baştan sona bağımsız biçimde tasarlayıp geliştirebilecek durumda değil. İnsanlar hâlâ araştırma hedeflerini belirleme, hangi problemin önemli olduğuna karar verme ve sonuçları değerlendirme konusunda önemli rol oynuyor.
Bununla birlikte aynı çalışma AI’ın AI geliştirme sürecini şimdiden hızlandırdığına dair dikkat çekici şirket içi veriler sunuyor.
Mayıs 2026 itibarıyla Anthropic kod tabanına eklenen kodun yüzde 80’den fazlasının Claude tarafından yazıldığı belirtiliyor. Şirketin tipik bir mühendisi 2024’e kıyasla günde yaklaşık sekiz kat daha fazla kod birleştiriyor. Anthropic bunun gerçek üretkenlik artışını olduğundan yüksek gösterebilecek kusurlu bir ölçü olduğunu da özellikle kabul ediyor.
Araştırma tarafında da benzer bir değişim var.
Bir deneyde Claude tabanlı ajanlara açık uçlu bir AI güvenliği problemi verildi. Ajanlar hipotez geliştirdi, deneyler yaptı ve sonuçları değerlendirdi. İnsan araştırmacılar yaklaşık bir haftada belirlenen performans farkının yüzde 23’ünü kapatırken ajanlar toplam 800 saatlik paralel çalışma sonunda yüzde 97’ye ulaştı.
Fakat sonuç üretim ölçeğindeki modellere temiz biçimde taşınamadı ve araştırma problemini seçen, başarı ölçütünü belirleyen yine insanlardı.
Bence tartışmanın en sağlıklı okuması burada.
AI henüz kendi halefini tamamen bağımsız geliştiren bir araştırmacı haline gelmiş değil.
Ama yapay zeka geliştiren insanların yaptığı işin giderek daha büyük bir bölümünü üstlenmeye başladı.
İki cümle aynı anda doğru olabilir.
Güncel risk değerlendirmeleri daha sakin bir tablo da gösteriyor
Korkutucu tahminleri konuşurken şirketin daha güncel teknik değerlendirmelerini görmezden gelmemek gerekiyor.
Anthropic’in Ağustos 2026 değerlendirmesinde mevcut modellerinin otomatik AI araştırma ve geliştirme için belirlediği kritik kapasite eşiğini henüz aşmadığı belirtiliyor.
Şirket, Claude Opus 5’in araştırmacı ve mühendislerin yerini almaya yakın olmadığını, AI kullanımının Anthropic’in AI geliştirme hızında sürekli iki katlık bir artış yarattığına dair gözlem bulunmadığını söylüyor. Opus 5 için ölçülen alignment riskini de çok düşük olarak değerlendiriyor.
Bu veri Coxon’ın gelecek tahminini çürütmüyor.
Coxon da Hubinger da ağırlıklı olarak ileride ortaya çıkabilecek çok daha güçlü sistemlerden endişe ediyor.
Ancak önemli bir denge sağlıyor.
Bugünkü Claude’un gizlice kendi süper zeki halefini geliştiriyor olduğu gibi bir tablo yok.
Tartışılan risk, mevcut eğilimin nereye ulaşabileceği konusunda.
Madem korkuyorlar, neden geliştirmeye devam ediyorlar?
Sanırım Coxon’ın paylaşımının en çok karşılık bulan bölümü burası.
Dışarıdan bakınca mantık çok basit görünüyor.
Bir teknolojinin insanlık için çok büyük risk taşıdığına inanıyorsanız onu geliştirmeyi bırakırsınız.
AI laboratuvarlarının dünyası bu kadar kolay işlemiyor.
Bir şirket kendi model geliştirme hızını düşürdüğünde rakibinin aynı şeyi yapacağını garanti edemiyor.
OpenAI yavaşlarsa Anthropic devam edebilir.
Anthropic durursa Google ilerleyebilir.
ABD’deki şirketler birlikte yavaşlarsa başka ülkelerdeki laboratuvarların devam etmesi mümkün.
Ortaya klasik bir koordinasyon problemi çıkıyor.
Her oyuncu topluca yavaşlamanın daha güvenli olabileceğini düşünebilir. Ancak tek başına yavaşlayan tarafın rekabet avantajını kaybetme ihtimali bulunuyor.
Sonuçta herkes istemediği bir yarışın içinde kalabilir.
Coxon, Anthropic’in içinde gördüğü davranışı tam olarak böyle yorumluyor. Şirketin riskleri anlamasına rağmen başka bir laboratuvarın daha sorumsuz hareket ederek önce ulaşacağı düşüncesiyle yarıştan çıkamadığını savunuyor.
Bu onun değerlendirmesi.
Fakat koordinasyon probleminin kendisi yalnızca Coxon’a ait bir iddia değil.
Anthropic’in resmi araştırması da aynı sorunu açık biçimde kabul ediyor.
Yarışı tek şirketin yavaşlaması çözmüyor
Haziran ayında yayımlanan çalışmanın en dikkat çekici bölümlerinden biri teknoloji kapasitesiyle ilgili grafiklerden sonra geliyor.
Anthropic, frontier AI geliştirmeyi güvenlik araştırmaları ve toplumsal kurumların yetişebilmesi için etkili biçimde yavaşlatmanın mümkün olması halinde bunun muhtemelen iyi bir fikir olacağını söylüyor.
Fakat tek taraflı yavaşlamanın daha az dikkatli aktörlerin öne geçmesine yol açabileceğini de ekliyor.
Bu nedenle şirket doğrulanabilir, koordineli bir yavaşlama veya geçici duraklama mekanizması üzerinde araştırma yapılmasını savunuyor.
Mantık şöyle.
Frontier seviyesindeki güçlü laboratuvarlar aynı koşullarda yavaşlamayı kabul edecek.
Her şirket diğerlerinin gerçekten durduğunu doğrulayabilecek.
Kimsenin anlaşmayı gizlice ihlal ederek avantaj kazanamayacağı mekanizmalar kurulacak.
Hangi koşulda durulacağı ve hangi koşulda yeniden başlanacağı önceden belirlenecek.
Anthropic, böyle güvenilir bir sistem kurulursa ve diğer frontier geliştiriciler de aynı şekilde hareket ederse kendisinin de yavaşlamasını veya geçici olarak durmasını beklediğini açık biçimde yazıyor.
Sorun bunu gerçekleştirmekte.
Yapay zeka yarışını denetlemek füze saymaktan daha zor olabilir
Anthropic’in kullandığı benzetme oldukça çarpıcı.
Nükleer silah anlaşmalarında bir füze silosunu gizlemek zor.
Devasa fiziksel altyapılar izlenebiliyor.
Yapay zeka eğitim çalışmaları ise veri merkezlerinin içinde gerçekleşiyor. Kullanılan çipler genel amaçlı. Eğitim çalışmasının tam olarak ne zaman başladığını ve hangi kapasiteyi hedeflediğini dışarıdan doğrulamak çok daha güç.
Üstelik diğer şirketler dururken gizlice devam eden bir laboratuvar çok büyük avantaj kazanabilir.
Bu nedenle koordinasyon yalnızca şirketlerin “tamam, yavaşlayalım” demesiyle çözülemiyor.
Doğrulama teknolojileri, ortak standartlar, devletler arası anlaşmalar ve güven gerekiyor. Anthropic de geçmişte benzer denetim rejimlerinin kurulmasının on yıllar alabildiğini hatırlatıyor.
AI tarafındaki tuhaflık ise zamanın bu kadar bol olmayabileceğine inanan araştırmacıların bulunması.
Coxon’ın tepkisinin sertliği biraz da buradan geliyor.
Daha önce güvenlik testlerinde başka bir eşiği görmüştük
Bu tartışma Fundalina’yı takip edenler için tamamen yabancı sayılmaz.
Temmuz ayında OpenAI’nin güvenlik testinden çıkan sarsıcı gerçek yazısında gelişmiş AI modellerinin kontrollü bir siber güvenlik değerlendirmesi sırasında test ortamından çıkarak gerçek sistemlere erişebilmesini ele almıştım.
Orada da dikkat çekici nokta modelin “kötü niyetli” olup olmadığı değildi.
Verilen hedefe ulaşmak için beklenmedik yollar geliştirebilmesi ve test altyapısındaki sınırların sandığımız kadar sağlam çıkmamasıydı. Daha sonra Anthropic de kendi siber güvenlik değerlendirmelerinde üç ayrı olayda Claude modellerinin üçüncü taraf test ortamlarından gerçek sistemlere ulaştığını açıkladı.
Daha önce sizlerle paylaşmıştım:
OpenAI’nin güvenlik testinden çıkan sarsıcı gerçek
Bu olaylar insanlığın kontrolünü kaybettiğini göstermiyor.
Ancak modellerin daha otonom hale geldikçe test, gözetim ve güvenlik altyapısının da aynı hızla gelişmesi gerektiğini gösteriyor.
Güvenlik problemi yalnızca modeli durdurmak değil
AI güvenliği denildiğinde çoğu zaman zihnimizde büyük bir kırmızı düğme beliriyor.
Bir şey ters giderse sistemi kapatırız.
Gerçek dünya daha karmaşık.
Bir model kod yazıyorsa hangi kodun inceleneceği önemli.
Başka ajanlara görev verebiliyorsa yetki sınırlarının belirlenmesi gerekiyor.
İnternete erişebiliyorsa hangi sistemlere ulaşabileceği kontrol edilmeli.
Kendi araştırma deneylerini çalıştırıyorsa başarı ölçütlerini kimin tanımladığı önem kazanıyor.
Daha güçlü modelin eğitimine yardım ediyorsa insan gözetiminin hangi aşamada devreye girdiği belirleyici oluyor.
Bu nedenle alignment yalnızca modelin “iyi davranmasını öğretmek” anlamına gelmiyor.
Modelin hedeflerini, yetkilerini, kararlarını ve insan müdahalesinin mümkün olduğu noktaları anlamayı da kapsıyor.
Daha önce AI Her İşi Yapabilse Bile Bazı İşleri İnsanlara mı Bırakmalıyız? yazısında teknolojinin yapabildiği şeylerle yapmasına izin vermeyi seçtiğimiz şeyler arasındaki ayrımı konuşmuştum.
Bugünkü tartışmanın başka bir yüzü de aynı yere çıkıyor.
Teknik kapasite artıyor.
Toplumsal sınırlar ise henüz aynı netlikte oluşmuş değil.
Karşı görüşte önemli belirsizlikler var
Bu yazıyı yalnızca Coxon ve Hubinger’ın endişeleri üzerinden bitirmek kolay olurdu.
Ancak elimizdeki veriler böyle kesin bir sonuca izin vermiyor.
Bugünkü frontier modeller kendi başlarına yeni nesil bir süper zeka tasarlayıp eğitemiyor.
Anthropic’in kendi çalışmasında modellerin iyi tanımlanmış deneyleri yürütme konusunda çok güçlendiği, buna karşılık hangi problemin araştırılacağına karar verme ve daha geniş araştırma yönünü belirleme konusunda insanların hâlâ önemli üstünlüğe sahip olduğu belirtiliyor.
Recursive self-improvement’ın gerçekten gerçekleşip gerçekleşmeyeceğini bilmiyoruz.
Gerçekleşirse ne kadar hızlı ilerleyeceğini bilmiyoruz.
Süper zekanın ne zaman ortaya çıkacağı konusunda bilimsel bir uzlaşma yok.
Böyle bir sistem ortaya çıkarsa insan kontrolünden çıkma ihtimalini güvenilir biçimde yüzdelendirebileceğimiz tarihsel veri de bulunmuyor.
Dolayısıyla yüzde 10, yüzde 20 veya başka bir extinction risk tahmini ölçülmüş fiziksel sabit gibi kullanılamaz.
Bunlar belirsiz bir geleceğe ilişkin uzman değerlendirmeleri.
Hatta aynı teknik gelişmelere bakan uzmanlar çok farklı sonuçlara ulaşabiliyor.
Bir grup recursive self-improvement’ın yakın olduğunu düşünüyor.
Başka araştırmacılar bugünkü mimarilerin gerekli araştırma muhakemesini kazanmasının çok daha zor olabileceğini savunuyor.
Bu belirsizlik yazının önemini azaltmıyor.
Bence tam tersine artırıyor.
Çünkü karar vermek zorunda olduğumuz dönem, sonucu bildiğimiz dönem olmayabilir.
Coxon’ın paylaşımı neden bu kadar büyüdü
Sosyal medyada AI hakkında her gün binlerce iddia dolaşıyor.
Coxon’ın paylaşımının saatler içinde teknoloji çevrelerinin çok ötesine taşınmasının birkaç nedeni var.
İlki içeriden gelmesi.
AI konusunda dışarıdan felaket senaryosu yazan biriyle OpenAI ve Anthropic’te doğrudan model eğitimi üzerinde çalışmış bir araştırmacının “Ben artık buna katkıda bulunmak istemiyorum” demesi aynı psikolojik etkiyi yaratmıyor.
İkincisi bedel ödemesi.
Yalnızca fikir paylaşmıyor. Dünyanın en güçlü teknoloji şirketlerinden birindeki görevinden ayrılıyor. Bu durum açıklamanın inandırıcılığını otomatik olarak kanıtlamasa da insanların dikkatini artırıyor.
Üçüncüsü kullandığı dil.
Recursive self-improvement, automated R&D veya alignment gibi teknik ifadelerin yerine herkesin anlayabileceği çok sert bir çelişki kuruyor.
Teknolojiyi geliştiren insanlar ondan korkuyor.
Ama geliştirmeye devam ediyorlar.
Dördüncüsü ise zamanlama.
Ajanların daha uzun görevler tamamladığı, AI’ın yazılım geliştirmede daha fazla iş yaptığı ve gerçek güvenlik testlerinde beklenmeyen davranışların görüldüğü bir dönemde geliyor.
Paylaşım bu nedenle yalnızca AI safety topluluğunun iç tartışması olarak kalmadı. Çok daha geniş bir güven problemine dönüştü.
AI şirketlerinden neden kendi kendilerini yavaşlatmalarını bekliyoruz
Burada uzun süredir teknoloji dünyasında tekrarlanan başka bir alışkanlığımız olduğunu düşünüyorum.
Yeni teknolojiyi şirketler geliştiriyor.
Risklerini şirketler açıklıyor.
Güvenlik standartlarını yine şirketler tasarlıyor.
Ne kadar hızlı ilerleyeceklerine büyük ölçüde şirketler karar veriyor.
Bir problem yaşandığında da çoğu zaman şirketlerin yeni güvenlik önlemleri açıklamasını bekliyoruz.
Bu yapı belirli bir ölçeğe kadar çalışabilir.
Ancak tartışılan teknoloji gerçekten ekonomiyi, güvenliği, bilimi ve siyasi güç dengelerini kökten değiştirebilecek kapasiteye ulaşırsa kararın yalnızca şirket yönetimlerinin sorumluluğunda kalması daha zor savunulur hale geliyor.
Coxon’ın paylaşımında beni en fazla düşündüren ifadelerden biri de buydu.
İnsanlığın geleceğini etkileyebilecek kararların özel bir şirketin iç iletişim kanallarında alınmasının yetersiz olduğunu savunuyor.
Söylemin dramatik tarafını bir kenara bırakırsak oldukça normal bir yönetişim sorusuna ulaşıyoruz.
Teknoloji şirketi kendi ticari yarışının hakemi olabilir mi?
İnovasyon ve güvenlik birbirinin karşıtı olmak zorunda değil
Burada kolayca “AI gelişimini durduralım” sonucuna da varmak istemiyorum.
Yapay zekanın bilimsel araştırmadan sağlığa, eğitimden erişilebilirliğe kadar yaratabileceği fayda çok büyük.
Anthropic de recursive self-improvement çalışmasında aynı noktaya dikkat çekiyor. AI’ın kendi geliştirme sürecini hızlandırmasının bilim ve sağlık gibi alanlarda olağanüstü ilerlemelere yol açabileceğini söylüyor.
Daha önce Yapay Zeka Bizim Adımıza Ödeme Yapmaya Hazır Peki Biz Hazır mıyız? yazısında benzer bir ayrım karşıma çıkmıştı.
Teknoloji ödeme yapabilecek seviyeye geliyor.
Kullanıcı ise o yetkiyi vermeye henüz aynı ölçüde hazır olmayabiliyor.
AI dünyasında tekrar tekrar aynı tabloyu görüyoruz.
Teknik olarak yapılabilir olmak ile toplumsal olarak hazır olmak aynı hızda ilerlemiyor.
Güvenlik tartışmasının değeri teknolojiyi durdurmaktan çok, bu mesafeyi fark etmemizde olabilir.
Beni düşündüren risk yüzdesinden çok yarışın kendisi
Jacob Coxon’ın haklı olup olmadığını bugün söyleyemeyiz.
Önümüzdeki on yılda insanlığın AI nedeniyle yok olma ihtimalinin yüzde 10’dan fazla olduğunu da doğrulayamayız.
Recursive self-improvement’ın birkaç yıl içinde başlayacağını bilmiyoruz.
Süper zekanın kontrol dışına çıkacağını da.
Bütün bunların önemli bir belirsizlik taşıdığını baştan kabul etmek gerekiyor.
Beni asıl düşündüren AI’ın insanlığı yok edip etmeyeceği tahmini değil.
Bunu bugün bilmiyoruz.
Daha önemli olan, teknolojiyi geliştiren insanların bir bölümünün riski ciddi görmesine rağmen yarışın devam ediyor olması.
Bir şirket yavaşlarsa diğerinin devam edeceğinden korkuyor.
Bir ülke yavaşlarsa başka bir ülkenin öne geçeceğinden endişe ediyor.
Her oyuncunun kendi açısından mantıklı davranışı, bütün sistem açısından daha riskli bir sonuç üretebilir.
Teknoloji tarihinde hız ve rekabet çoğu zaman inovasyonu geliştirdi.
Yapay zeka tarafında ilk kez hızın kendisinin de yönetilmesi gereken bir risk olup olmadığını bu kadar ciddi biçimde tartışıyoruz.
Belki Coxon’ın paylaşımından geriye kalacak en önemli şey felaket tahmini olmayacak.
Bize hızın kimin kararı olduğunu yeniden sordurması olacak.
Bu kadar büyük sonuçları olabilecek bir teknolojinin geliştirme hızına kim karar vermeli?
